مدلهای جهانی؛ تلاش گوگل، انویدیا و متا برای فهم فیزیک
هوش مصنوعی در نوشتن متن مهارت دارد اما در عمل فیزیکی مانند برداشتن گلدان شیشهای ناتوان است؛ گوگل، انویدیا و متا برای توسعه «مدلهای جهانی» وارد رقابت شدهاند.
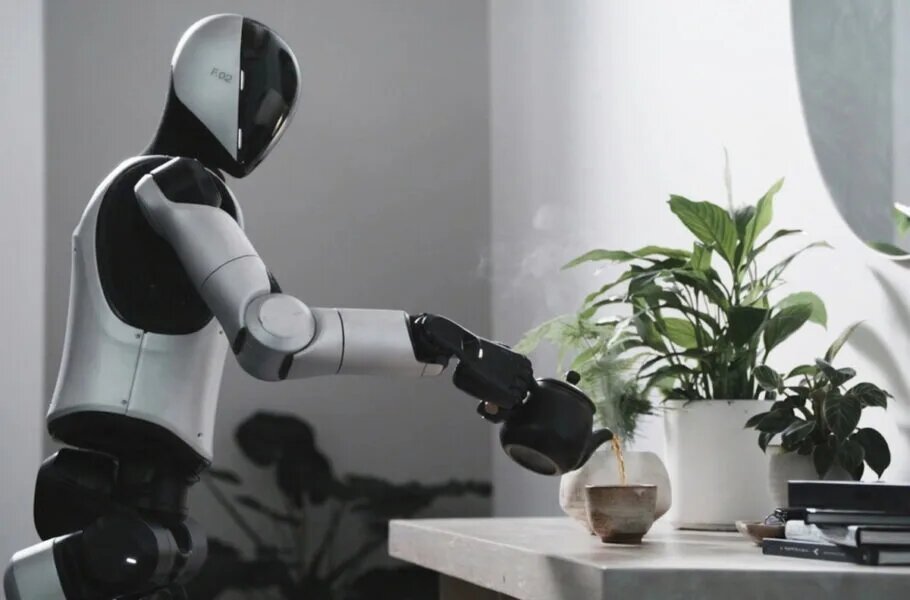
به گزارش تبریز فوری به نقل از ایسنا، هوش مصنوعی در سالهای اخیر یاد گرفته متن بنویسد، شعر بگوید و مفاهیم پیچیده را خلاصه کند، اما در عمل فیزیکی ساده ناکام میماند. اگر از همین سیستم بخواهید یک گلدان شیشهای نازک را از روی میز آشپزخانه بردارد و روی طاقچه بگذارد، دقیقترین مراحل را ارائه میدهد اما دست مکانیکی ربات با اولین فشار گلدان را خرد میکند.
این پرسش، به گزارش ایسنا به نقل از دیجیاتو، محور رقابت تازه گوگل، انویدیا و متا برای توسعه «مدلهای جهانی» (World Models) است؛ سیستمی که قرار است پای ماشینها را در عمل به دنیای واقعی باز کند. مشکل این است که چتباتها فقط توصیف دنیا با کلمات را یاد گرفتهاند، بدون درکی از سنگینی سنگ، لیزی روغن یا شکنندگی بلور.
بنبست کلمات؛ چرا چتباتها دنیای واقعی را نمیفهمند؟
مدلهای زبانی بزرگ مثل ChatGPT با بلعیدن میلیاردها صفحه متن در نوشتن و کدنویسی مهارت دارند، اما منطق پشت پرده آنها حدس زدن کلمه بعدی در یک جمله است و درکی از فیزیک جهان ندارند.
در مقابل، یک کودک دو ساله بدون دانستن جاذبه، با تماشای افتادن اسباببازی روی فرش و گرفتن لبه میز، یک مدل ذهنی از جهان میسازد؛ دانشی شهودی که حاصل نگاه کردن، حرکت و لمس مواد است، نه خواندن متن.
«یان لکان» (Yann LeCun) از پدران یادگیری عمیق میگوید باد کردن مدلهای زبانی با خواندن متون بیشتر هرگز ما را به هوش مصنوعی در سطح انسان نمیرساند. از نظر وی هوش واقعی زمانی شکل میگیرد که ماشین بتواند از دنیای فیزیکی یاد بگیرد، اتفاقات بعدی را پیشبینی کند و بر اساس پیشبینیها دست به عمل بزند.
مغز انسان بهطور مداوم عواقب کارها را قبل از انجام شبیهسازی میکند؛ از تخمین سرعت ماشینها هنگام عبور از خیابان تا برداشتن لیوان آب یا چیدن جعبهها روی هم. متخصصان تلاش میکنند همین قدرت پیشبینی و شبیهسازی درونی را به ماشینها بدهند.
دو فلسفه متفاوت: دعوای علمی لکان و هاسابیس
در خط مقدم این فناوری، یان لکان و دمیس هاسابیس، مدیرعامل گوگل دیپمایند، هر دو قبول دارند که هوش مصنوعی باید فیزیک دنیا را بفهمد اما مسیرشان فرق میکند.
دیدگاه یان لکان حذف جزئیات اضافه است. او میگوید دنیای فیزیکی پر از جزئیات غیرقابل پیشبینی و بیفایده برای تصمیمگیری است. وقتی گربهای از دیوار میپرد، جهت پریدن و نقطه فرود مهم است، نه تکان تارهای مو در هوا. اگر هوش مصنوعی بخواهد تکتک پیکسلهای ویدیوی آینده را تولید کند، توان پردازشی را صرف جزئیات بیاهمیت میکند. روش پیشنهادی او معماری JEPA است که در آن هوش مصنوعی بهجای بازسازی تصویر آینده، اطلاعات را به بازنمایی فشرده و ریاضی تبدیل میکند و آینده محیط را در همان فضا حدس میزند.
در سوی دیگر، دمیس هاسابیس باور دارد تماشای میلیاردها ساعت ویدیو از رفتار دنیا، از ریختن چای در لیوان تا برخورد موج به صخره، به مدلها سازوکار دنیا و رابطه علت و معلولی را یاد میدهد. او معتقد است وقتی مدلی جریان روان آب را طبیعی میسازد، تا حدی به فیزیک شهودی ماده دست یافته است، هرچند خودش قبول دارد ساختن ویدیوی واقعی به معنی فهم قوانین مکانیک و ترمودینامیک نیست، اما آن را گامی کلیدی برای رسیدن به هوش مصنوعی جامع (AGI) میداند.
چهار پروژه پیشتاز: بازی، پردازش و عمل مکانیکی
پروژه Genie 4 گوگل دیپمایند بهجای ساختن ویدیوهای ثابت، روی محیطهای تعاملی تمرکز کرده؛ شبیه بازی ویدیویی که در لحظه توسط هوش مصنوعی خلق میشود. کاربر جنگلی را توصیف میکند، وارد آن میشود و با دستور متنی هوا را بارانی میکند. نسخه Genie 4 محیطهای واقعیتر را بهصورت زنده میسازد، صداهای محیطی، موسیقی و دیالوگهای تعاملی تولید میکند و به خانواده مدلهای جمینای، بهویژه Omni، متصل است. بزرگترین کاربرد آن آموزش رباتهاست تا هزاران بار در زمین تمرین مجازی اشتباه کنند، بدون آسیب در دنیای واقعی.
پروژه Cosmos 3 انویدیا پلتفرمی برای نزدیک کردن درک محیط، پیشبینی اتفاقات بعدی و اقدام مناسب است. معماری آن دو بخش دارد: شبکه استدلالگر برای تحلیل اطلاعات تصویری، متنی، صوتی و حرکتی، و بخش مولد مبتنی بر دیفیوژن برای تولید تصویر، ویدیو و مسیرهای حرکتی. انویدیا دو اندازه معرفی کرده: نسخه نانو با ۱۶ میلیارد پارامتر برای ورکاستیشن و نسخه سوپر با ۶۴ میلیارد پارامتر برای دیتاسنتر.
پروژه V-JEPA 2 متا بر پایه نظریههای لکان است و میگوید برای فهم قوانین فیزیک نیازی به بازسازی تکتک پیکسلها نیست. این مدل با تماشای بیش از یک میلیون ساعت ویدیوی عمومی و با خودآموزی و بدون برچسب انسانی آموزش دیده است. نسخه V-JEPA 2-AC با ۶۲ ساعت ویدیوی حرکات بازوی مکانیکی ربات فرانکا آموزش دید و توانست در آزمایشگاهی نادیده، با نرخ موفقیت ۶۵ تا ۸۰ درصدی وسایل را بردارد و جابهجا کند. روش کار آن تبدیل وضعیت فعلی و تصویر هدف به بازنمایی ریاضی و شبیهسازی حرکتهای احتمالی برای نزدیک شدن به هدف است.
پروژه Atlas از شرکت World Labs که «فیفی لی» از دانشمندان بینایی کامپیوتر تأسیس کرده، متون، تصاویر و فیلمها را به فضای هندسی سهبعدی باثبات تبدیل میکند. هدف آن آوردن هوش فضایی به ماشینهاست.
از آزمون تا ایمنی: قفل رباتیک چگونه باز میشود؟
رباتهای فعلی خطوط تولید در محیطهای کاملا کنترلشده کار میکنند، اما ربات خانه، بیمارستان یا انبار شلوغ با شرایط متغیر روبهروست؛ لیوان پشت کتری است یا کودکی جلوی ربات میدود. مدلهای جهانی در سه بخش میتوانند کمک کنند: کاهش هزینه آموزش با تمرین میلیونها ساعت در شبیهسازی، تصمیمگیری منعطف در لحظه بدون قفل شدن با مانع غیرمنتظره، و آمادگی برای اتفاقات نادر مانند پریدن عابر در شب بارانی با شبیهسازی هزاران سناریو.
با این حال، گزارش تحقیقی رسانه Ars Technica در جولای ۲۰۲۶ با پژوهشگران دانشگاه MIT، شرکت Runway و World Labs نشان میدهد هنوز حتی روی تعریف واحدی از مدل جهانی توافق نیست. محققان دانشگاه استنفورد نیز هشدار دادهاند هیچ معیار قابل اتکایی برای امنیت این مدلها در سیستمهای حساس وجود ندارد. برای راستیآزمایی از سه روش استفاده میشود: سنجش آزمایشگاهی با حسگر دقیق، آزمایش مستقیم روی رباتهای فیزیکی، و برخورد با شرایط ناشناخته مانند ماده ژلهای دیدهنشده. گروهی از پژوهشگران بنچمارکی با نام WMEval معرفی کردهاند که با شبیهسازی Unity مدلها را از نظر کنترلپذیری، ثبات اشیا، حرکت اجسام، رفتار مایعات و روابط علت و معلولی میآزماید.
بزرگترین کابوس، توهم توأم با عمل است؛ اگر ربات حدس بزند قفسهای نازک تحمل دویست کیلو را دارد، نتیجه ویرانی و مصدومیت است. رفتار انسان نیز خطی نیست. برای جلوگیری، دانشمندان روی تخمین عدم قطعیت کار میکنند تا مدل بگوید مطمئن نیستم و از کار پرریسک دست بکشد، و سیستمهای ایمنی مستقل شامل سنسور مجزا و محدودکننده مکانیکی بهعنوان ناظر عمل کنند.
آینده متعلق به ترکیب مدل زبانی و مدل جهانی است. مدل زبانی نقش برنامهریزی کلان و مدل جهانی نقش درک فیزیکی را دارد؛ وقتی گفته شود میز ناهارخوری را جمع کن، مدل زبانی دستور را به مراحل تقسیم میکند، مدل جهانی عواقب فیزیکی را شبیهسازی میکند و سیستم کنترلی آن را به دستور حرکتی تبدیل میکند.
منبع: www.isna.ir
افزایش معدل دانشجویان شریف و پرسش از کارآمدی شیوههای امتحان